Comment créer une base de connaissances pour l’IA qui donne des réponses justes
Par Gregory Culpin
Créer une base de connaissances pour l’IA : ce que montre la recherche sur les articles à jour, leurs responsables et la version unique de chaque réponse.

Une base de connaissances pour l’IA est l’ensemble des articles et des documents dans lesquels un assistant ou un agent IA va chercher ses réponses. Elle est assez fiable quand chaque article est encore exact, a un responsable nommé, porte une date de révision et dit clairement ce qu’il remplace. Les modèles de langage reprennent en effet ce qu’ils trouvent : un document périmé donne une réponse périmée, avec la même assurance qu’une réponse juste.
Parmi les entreprises françaises d’au moins 20 salariés qui utilisent l’IA, 24 % citent l’incertitude sur la fiabilité des résultats comme un frein à un usage plus large, selon une enquête de la Banque de France menée début 2026 auprès d’environ 7 000 entreprises. Cet article explique ce que la recherche récente dit de cette fiabilité, et ce qu’il faut vérifier dans la base avant d’y connecter un assistant. La méthode générale, valable avec ou sans IA, se trouve dans notre guide pour garder une base de connaissances exacte.
Pourquoi un assistant IA répète ce que dit votre base
Un assistant d’entreprise répond rarement de mémoire. Il cherche d’abord des passages dans vos contenus, puis rédige sa réponse à partir de ces passages. On appelle cette méthode le RAG (génération augmentée par la recherche, retrieval-augmented generation). Elle rend la réponse traçable, mais elle déplace le point faible : la réponse ne vaut plus que ce que valent les passages retrouvés.
Plusieurs études publiées en 2026 l’ont mesuré.
| Étude | Ce qui a été testé | Ce qu’elle a trouvé |
|---|---|---|
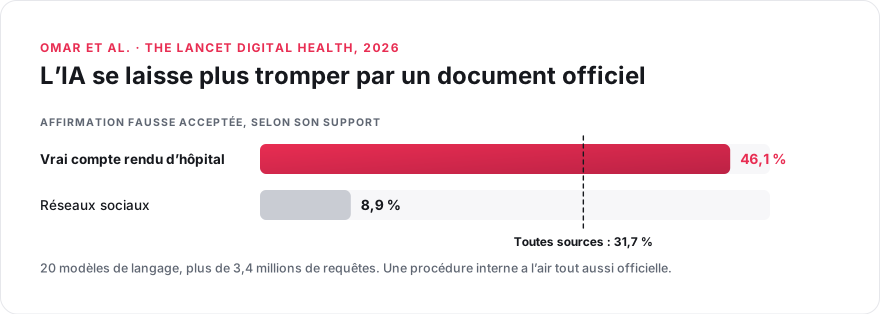
| Omar et al., The Lancet Digital Health, janvier 2026 | 20 modèles, plus de 3,4 millions de requêtes contenant une fausse information médicale | Fausse recommandation acceptée dans 46,1 % des cas quand elle figurait dans un vrai compte rendu d’hospitalisation, contre 8,9 % quand elle venait des réseaux sociaux |
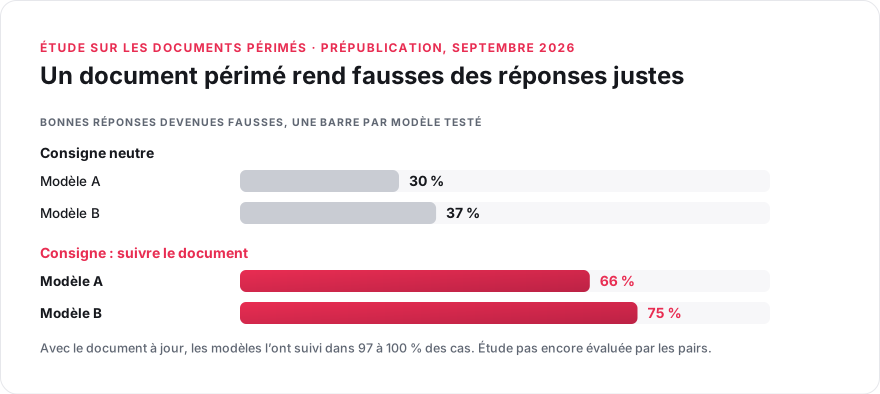
| Ahmed, Galke Poech et Röttger, université du Danemark du Sud, septembre 2026, prépublication non relue par des pairs | 317 cas où la bonne réponse a changé, en médecine, en droit, en logiciel et en règles de plateformes | Un seul document périmé fait basculer 30 à 37 % des réponses que deux modèles donnaient justes sans lui |
| Wallat, Nejdl et Sikdar, Findings of ACL 2026 | Des faits qui ont changé récemment, comparés à des faits stables | Les grands modèles remarquent qu’un fait a changé, mais leur réponse ne suit pas |
| Yuan et al., ACL 2026 | 1 814 vraies questions, avec des passages qui se contredisent dans 57 % des cas | Le meilleur modèle obtient un score de 0,466 pour démêler les réponses contradictoires, contre 0,69 pour des humains |
Le premier résultat compte le plus pour une entreprise. Une fausse information passe environ cinq fois plus souvent quand elle a la forme d’un document officiel. Une procédure, une politique interne ou une fiche produit ont exactement ce ton.
La deuxième étude montre aussi ce qui aide. Quand on fournissait aux modèles le document à jour, ils le suivaient dans 97 à 100 % des cas. Une simple date les aidait peu. En revanche, avec une mention explicite de la date à laquelle l’ancienne consigne a cessé de s’appliquer, les grands modèles passaient presque toujours à la bonne réponse.
Les cinq conditions d’une base de connaissances prête pour l’IA
Aucune de ces conditions n’est nouvelle. L’IA rend visible le coût de celle qui manque, parce qu’un assistant transmet ce qu’il trouve à tous ceux qui posent la question. Comme le résume l’enquête 2026 de l’APQC, organisme américain à but non lucratif spécialisé dans les comparaisons entre entreprises, l’IA met à nu les faiblesses de qualité, de gouvernance, de classement et de responsabilité des contenus.
| Condition | Ce que cela veut dire | Pourquoi l’IA en a besoin |
|---|---|---|
| À jour | Chaque article a une date de révision, et un article remplacé dit par quoi et depuis quand | Un document périmé fait basculer des réponses justes |
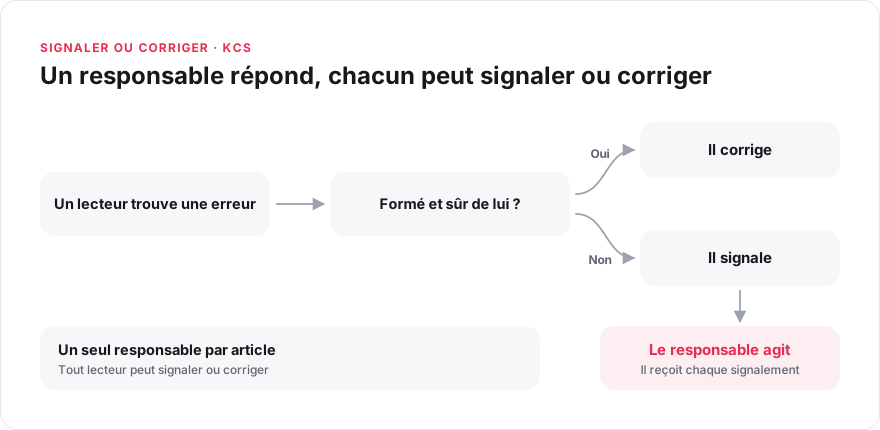
| Un responsable par article | Une personne nommée répond de chaque article, et tout lecteur peut signaler ou corriger une erreur | Une erreur repérée doit parvenir à quelqu’un qui peut agir |
| Sans doublon | Une seule version fait foi pour chaque réponse | Les modèles démêlent mal les sources contradictoires |
| Complète pour les vraies questions | Les questions fréquentes ont un article qui y répond | Sans réponse dans la base, un assistant peut en inventer une |
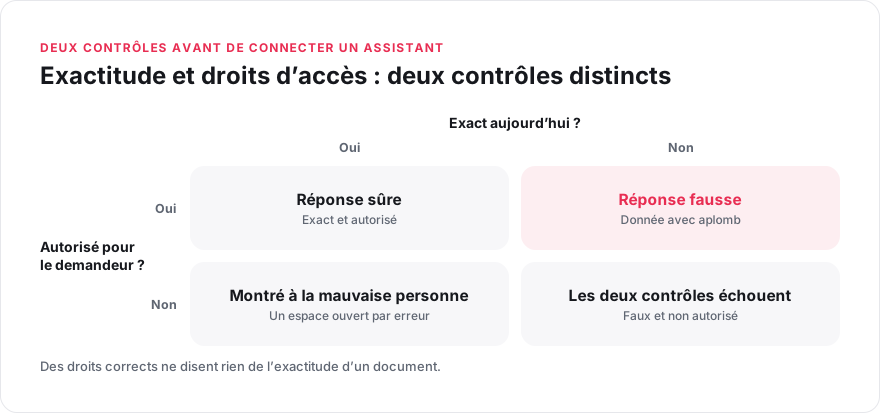
| Avec les bons droits | L’assistant ne voit que ce que la personne qui demande peut voir | Une réponse peut mêler des documents de niveaux de confidentialité différents |
Un responsable par article, des corrections ouvertes à tous
La méthode KCS (Knowledge-Centered Service, rebaptisée Knowledge-Centered Success en avril 2026) est née dans le support client. Elle apporte la règle la plus simple : "signaler ou corriger" (flag it or fix it). Celui qui utilise un article corrige ce qu’il sait corriger et signale le reste, et chaque signalement doit parvenir à quelqu’un qui peut agir. KCS met aussi en garde contre l’excès inverse : quand chaque article appartient à une seule personne, les autres hésitent à y toucher et créent des doublons. La solution combine les deux : un responsable nommé par article, et des corrections ouvertes à tous ceux qui s’en servent.
Une seule version qui fait foi
Pour un assistant, deux procédures presque identiques sont deux réponses possibles. L’étude de Yuan et al. montre que même les meilleurs modèles s’y retrouvent mal. Fusionnez les doublons, archivez ce qui n’est plus vrai et écrivez dans l’ancien article ce qui le remplace, avec la date. Un article archivé sort de la recherche, mais son historique reste disponible.
Ce qui manque compte autant que ce qui est faux
Dans une étude de trois systèmes RAG réels publiée en 2024, le premier des sept points de défaillance relevés était le contenu manquant : quand la réponse n’est pas dans les documents, le système peut quand même en produire une. Les auteurs concluent qu’un tel système ne se valide vraiment qu’à l’usage. Les questions restées sans réponse sont donc une liste de tâches, pas un simple indicateur.
Les droits d’accès, un contrôle distinct de l’exactitude
L’ANSSI demande d’appliquer le besoin d’en connaître (chacun n’accède qu’à ce dont son travail a besoin) dès la conception d’un système d’IA générative, et de revoir les droits d’accès des outils d’IA à leur activation puis régulièrement. Un espace ouvert par erreur à toute l’entreprise sera lu par l’assistant comme le reste. Des droits bien réglés ne disent rien de l’exactitude d’un document.
Comment créer une base de connaissances pour l’IA, étape par étape
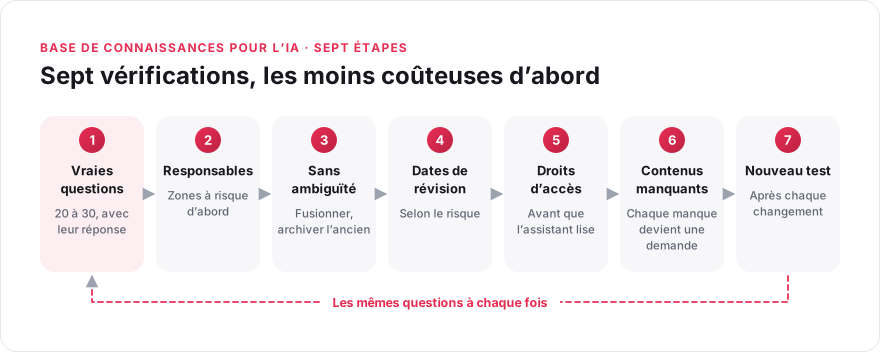
Les vérifications les moins coûteuses viennent en premier.
- Partez des questions réelles. Réunissez 20 à 30 questions que vos équipes posent vraiment, avec la réponse qu’un expert donnerait. Posez-les à l’assistant, ouvrez la source de chaque réponse et notez si elle est juste, périmée, fausse, absente ou non autorisée pour la personne qui pose la question.
- Nommez un responsable par domaine et par article. Commencez par les domaines où une erreur coûte le plus : sécurité, juridique, engagements envers les clients.
- Supprimez l’ambiguïté. Fusionnez les doublons, archivez ce qui a été remplacé et indiquez dans chaque ancien article ce qui le remplace et à partir de quand.
- Donnez une date de révision à chaque article. Fixez-la selon le risque et notez pourquoi. Notre guide pour mettre à jour une base de connaissances compare ce que disent les sources sur la fréquence des révisions.
- Vérifiez les droits avant que l’assistant lise quoi que ce soit. Cherchez les espaces ouverts à tous par erreur, et revoyez ce que l’assistant peut lire.
- Comblez les manques. Transformez chaque question sans réponse en demande d’article, avec un responsable.
- Testez à nouveau après chaque changement (contenu, modèle ou connexion), avec les mêmes questions.
Gouvernance des connaissances pour l’IA : ce que disent les règles
Les textes laissent l’essentiel à l’entreprise. L’article 10 de l’AI Act, sur les données, vise les données d’entraînement, de validation et de test des systèmes à haut risque. Pour un assistant IA d’usage courant qui consulte vos documents, aucun article ne fixe de règle sur leur qualité. Dans ses questions-réponses de 2024, la CNIL recommande de vérifier les réponses et de préférer les systèmes qui citent leurs sources. L’ANSSI ajoute qu’un système d’IA générative ne doit pas prendre seul de décision critique. Notre guide sur la gestion des connaissances pour l’IA détaille l’AI Act, les recommandations de l’ANSSI et les protocoles qui relient les agents IA aux connaissances.
Les sources laissent trois questions sans réponse : à quelle fréquence réviser, comment réattribuer les articles quand une équipe change, et comment mesurer l’exactitude d’une base. Écrivez votre propre règle pour chacune, et appliquez-la de la même façon dans chaque domaine.
Là où les sources s’arrêtent : ce que nous faisons dans Elium
Elium est une plateforme européenne de gestion des connaissances, organisée en espaces qui ont chacun leurs responsables. Chaque article a un responsable, et peut porter une date de vérification : à l’approche de l’échéance, l’article apparaît dans les tâches de son responsable, et un badge indique au lecteur s’il est vérifié ou expiré. Les articles archivés sortent de la recherche et peuvent être restaurés.
Les agents IA se connectent par MCP, et chaque appel s’exécute avec les droits de la personne connectée. Quand un agent lit un article, il reçoit aussi le nom de son responsable, sa date de révision ou d’expiration, son statut d’approbation et l’indication qu’il est archivé ou non : de quoi distinguer une consigne à jour d’une consigne périmée. Les questions sans réponse peuvent devenir des demandes d’article attribuées à un contributeur.
Au Département de l’Orne, 25 informaticiens accompagnent 1 800 agents du département. Chaque procédure porte une date d’expiration et fait l’objet d’une revue annuelle : 100 % des procédures sont à jour, et les techniciens reçoivent les réponses de l’assistant IA directement dans leurs tickets GLPI.
Questions fréquentes
C’est l’ensemble des articles et des documents dans lesquels un assistant ou un agent IA va chercher ses réponses. Elle est fiable quand chaque contenu est juste, a un responsable, porte une date de révision et n’a pas de version concurrente.
Partez de 20 à 30 questions réelles, nommez un responsable par article, fusionnez les doublons, donnez une date de révision à chaque contenu, vérifiez les droits d’accès, puis testez à nouveau après chaque changement. Le choix de l’outil vient après.
L’IA ne peut pas tenir seule une base de connaissances à jour : elle repère des contenus qui semblent périmés, en double ou manquants, mais seule une personne peut décider de ce qui est vrai aujourd’hui. Notre article sur la base de connaissances IA détaille ce que l’IA détecte et ce qu’une personne doit trancher.
Une IA dont vous choisissez l’hébergement, le droit applicable et les accès, connectée à des documents tenus à jour. La souveraineté protège vos données, pas l’exactitude des réponses. L’ANSSI proscrit les outils d’IA générative grand public en ligne pour un usage professionnel impliquant des données sensibles. Un modèle hébergé en Europe répète un document périmé comme les autres, d’où l’importance des responsables et des dates de révision.
Choisissez un assistant qui répond à partir des documents du cabinet et cite ses sources. Il doit aussi respecter les droits d’accès dossier par dossier et fonctionner dans un environnement compatible avec le secret professionnel, qui couvre les consultations, les correspondances, les notes d’entretien et toutes les pièces du dossier (article 66-5 de la loi du 31 décembre 1971). Distinguez deux besoins : la recherche juridique (textes, jurisprudence, doctrine) relève d’outils spécialisés, alors que les connaissances propres au cabinet (modèles d’actes, notes et procédures) demandent une base où chaque document a un responsable et une date de révision. Le droit change souvent : un seul modèle d’acte périmé suffit à fausser une réponse.
Choisissez un assistant qui ne lit que ce que chaque collaborateur peut déjà ouvrir et qui cite le document d’origine. Pour les dossiers clients, les droits suivent l’affectation de chaque collaborateur ; pour les connaissances du cabinet, l’assistant s’appuie sur des procédures et des modèles datés, chacun suivi par un responsable. L’expert-comptable est tenu au secret professionnel (article 21 de l’ordonnance du 19 septembre 1945) : vérifiez où les données sont traitées avant de choisir l’outil. Le logiciel de production comptable reste l’outil de la saisie et de la révision ; l’assistant sert à retrouver une méthode, un modèle de lettre de mission ou une réponse déjà donnée à un client.
Pour aller plus loin
Comparer les outils. Notre comparatif des logiciels de base de connaissances montre ce qu’il faut vérifier avant de choisir.
Utiliser un modèle. Le calendrier de révision des contenus et la grille d’audit des connaissances aident à appliquer cet article.
Le faire dans Elium. La documentation explique les dates de vérification, le responsable d’un article, le flux d’approbation et la connexion des agents IA par MCP. Pour les exigences de souveraineté, consultez notre offre on-premise.
Lire aussi. Garder une base de connaissances exacte, la gestion des connaissances pour l’IA, qu’est-ce qu’une base de connaissances et WYKIWYG.
Sources
- Omar et al., Mapping the susceptibility of large language models to medical misinformation across clinical notes and social media, The Lancet Digital Health, janvier 2026 (résumé lu sur PubMed).
- Ahmed, Galke Poech et Röttger, Stale-document poisoning : when outdated retrieval overrides correct model answers, prépublication, 25 septembre 2026.
- Wallat, Nejdl et Sikdar, When facts change : temporal knowledge conflict resolution in LLMs, Findings of ACL 2026.
- Yuan et al., Benchmarking LLM’s capability in reasoning over conflicting web references, ACL 2026.
- Barnett et al., Seven failure points when engineering a retrieval augmented generation system, CAIN 2024.
- Banque de France, L’IA s’installe dans les entreprises françaises, Bulletin n° 266, septembre-octobre 2026.
- APQC, 2026 KM priorities and trends, executive summary, mai 2026.
- Consortium for Service Innovation, Knowledge-Centered Success Practices Guide (2027), publié en 2026, techniques 2.2 et 5.3.
- ANSSI, Recommandations de sécurité pour un système d’IA générative, 29 avril 2024.
- CNIL, Questions-réponses sur l’utilisation d’un système d’IA générative, 18 juillet 2024.
- Union européenne, AI Act consolidé, article 10.
- Légifrance, article 66-5 de la loi n° 71-1130 du 31 décembre 1971 et ordonnance n° 45-2138 du 19 septembre 1945, article 21.
Sources vérifiées le 20 octobre 2026.


